问答 · 动作
怎样用 AI 视频规划一镜到底的动作镜头?
更新于 2026 年 10 月 31 日

一镜到底要求流水线守住什么
剪切是用来藏拙的地方。一场打斗、追逐或穿行,剪辑拼接之后,每一次剪切都会重置空间关系,原谅换了的服装,并让下一个角度凭空造出一个新房间。一镜到底把这些全都禁止了:镜头不停地穿过空间,所以位置、行进方向、手里的道具和脸上的光线,必须在整段过程中保持一致。
这也是为什么一镜到底是观众记得住的镜头,也是创作者烧预算的镜头——真人摄制组需要排练,生成式视频则需要规划,因为模型会乐于生成一个漂亮的连续镜头,而其中的房间在移动途中自己重新布置。语料中关于运动的问题数量很大:有 520 条帖子问怎么一比一复制动作。答案不是某个设置,而是把长镜头写成各部分无法互相矛盾的样子。
先写路径,再写镜头
把长镜头当作一次旅程来规划,用一句话说出来:镜头从快递员身后进入,沿着小巷跟着她,随她一起从卷帘门下钻过,最后停在掉落的包裹上。这句话就是镜头的主干。然后把旅程拆成节拍——节拍在动作发生实质变化的地方结束——并在分镜中把每个节拍写成带自己秒数的镜头。这些镜头不是剪切;它们是一次连续运动的时间标尺,而且它们的秒数在生成任何东西之前都可以免费编辑,这就是你调整镜头节奏的方法。
像描述真实房间那样描述空间:家具在哪里、门在哪一侧、光从哪里来。含糊的房间正是连续镜头会暴露的东西——墙动了的话,没办法切走。分镜对位置和方向做出的每一个说法,都是长镜头在整个过程中必须保持为真的,所以最省钱的规划工具并不起眼:少几个节拍,每个都定位清楚。
一个片段,还是几个?
长镜头能放进单次生成上限,是最简单的情形:一个片段、一次请求,在 Seedance 2.0 上最长 15 秒,面向相应档位的三十秒片段长度也可选。一个片段内部完全没有接缝,对于单个动作节拍,十五秒的画面时间通常绰绰有余。
更长的镜头把片段串成链,链遵循一条规则:下一个片段从上一个结束的地方开始。在接缝处保护幻觉的是方向——让镜头的朝向和主体的行进在衔接处保持连续,避免在接缝处出现反向或突然换话题,那会读成这个长镜头承诺过不做的剪切。接缝也是重新生成某个片段发挥价值的地方:把返回结果不对的那一个片段修好,而不是重建整个长镜头。
把房间固定住
对付空间漂移,机器这一侧的答案是一份三维的规划。在一个场景的镜头被生成之前,本站会先把场景做成一个简单的三维布局——房间是方盒子、保留重要的家具、每个人是一个朴素的人形——并为每个镜头算出一个位置安排:每个人在哪里,镜头可以站在哪里看到他们。这一遍只固定四件事,别的不管——镜头在哪里、画面多宽、每个人在空间里的位置,以及镜头在哪里切换——而这份规划正是让座位、门、墙、谁站在谁旁边这些在整个长镜头里保持不变的原因。这也是为什么镜头只会切到房间里真实存在的角度;它由你的分镜和场景图生成,这也是上一节重要的另一个原因:你写的时候不是在和规划对抗,而是在给它提供素材。
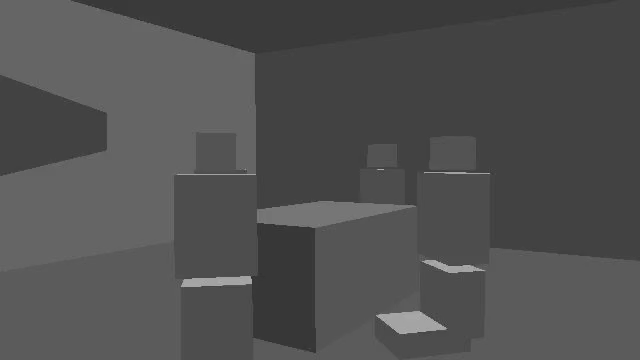
有两个习惯能让这份规划派上用场。把位置明确写出来,而不是想当然——谁坐在桌子上首、谁在门边——并让长镜头里的角色保持精简:连续画面里每多一张脸,镜头就多一个要盯着的人。长镜头最好有一个主体、一个追逐者和一个房间。
通常什么会弄坏连续长镜头
- 长镜头做不到的变化。换装、新增的伤口或拔出的武器,改变的是物体是什么,而不是它在哪里——每一项都需要为相关片段选好各自的参考图。镜头中途的变身是状态问题,不是镜头问题。
- 需要单独覆盖的节拍。如果规划暗地里想要在一次不间断的运动里同时有特写、反应镜头和远景,长镜头一个也满足不了。要先决定这个长镜头是为了什么:空间关系、冲劲,还是揭示。
- 人群与车流。背景人物是场景层面的设定,不是逐节拍即兴发挥;人群没有管理的长镜头,就是每一秒都换一批人群的长镜头。
- 边走边说的台词。运动中说的台词,需要在镜头文字里写明秒数,与其他镜头完全一样;长镜头不会放宽时间规则,而是把它们成倍放大。

运动类问题怎么分
两个最大的运动问题分得很清楚:一个问怎么复制动作,一个问怎么搭建长镜头。两者都是同一块缺失的拼图造成的声量——一份关于东西在哪里的规划:
| 问题(近乎相同的帖子) | 帖子 |
|---|---|
| 动作复制的问题 | 520 |
| 一镜到底的问题 | 150 |
计划奏效时,观众会用一句话告诉你——这条评论就是每个连续动作段落都要对照的标准:
太棒了。这是我见过最连贯的 AI 动作片段之一。
“连贯”是关键词:不管这段画面做了什么,它都没有丢掉那个空间。这条评论出自 r/aivideo 里的一场讨论。
局限:这一页没有涵盖的内容
- 一镜到底是一种选择,不是美德。多机位覆盖——全景、特写、反应镜头——才是大多数动作戏的实际做法,节奏快、拍点细碎的戏,剪开来通常比一镜拉到底更好看。
- 生成的镜头仍然需要检查:画面怎么动由模型决定,所以要给出错的那个片段留出重新生成的预算,并且在重来之前先把分镜文字修正好。
- 一个镜头中途必须换地点,就是两个镜头在接缝处相连,不管文字怎么写都一样;这道接缝要有意识地规划,而不是等撞上了才发现。
- 这里的数量是按规则在固定时间窗口内得出的近似值,引用的赞美也只是一位观众的感受,不是基准测试。
常见问题
单个长镜头最长能多长?
一个片段在 Seedance 2.0 上最长 15 秒,在支持长镜头的档位上最长三十秒。更长的连续动作就要把片段串起来,每一段从上一段结束的地方开始——只要朝向是接着的,接缝处就是衔接,而不是剪切。
我需要把运镜的每一步都写出来吗?
写旅程,不写编舞:入场、镜头跟随什么、停在哪里,以及中间的各个节拍和它们的秒数。镜头给整个长镜头定下时间,位置描述则给它一个可以穿行的空间。
模型还是自己加了一刀剪切怎么办?
先当作镜头文字的问题:把连续性写明确——朝向、主体、结束时的位置——然后重新生成这个片段。如果两次都以同样的方式失败,就在它总出问题的那个节拍处把长镜头拆开;有计划的接缝,好过没计划的剪切。
长镜头里可以有人群或街上的车流吗?
可以,前提是在场景层面声明人群并始终遵守——背景里的人是这个地点的常驻状态,而不是每个节拍都重新发明一遍。没有声明的人群,在长镜头的每一秒里看起来都像换了一批人。
还有两篇指南讲得更深:空间一致性是如何保持的和如何用生成的片段预演一次真实拍摄讲的是具体机制,而姊妹篇回答做到一分钟以上讲了本页默认你已掌握的片段算术。方法说明介绍了这类数量是怎么统计出来的。