复刻:台词和配乐是怎么从原片里读出来的、最后进到你这一集的是什么
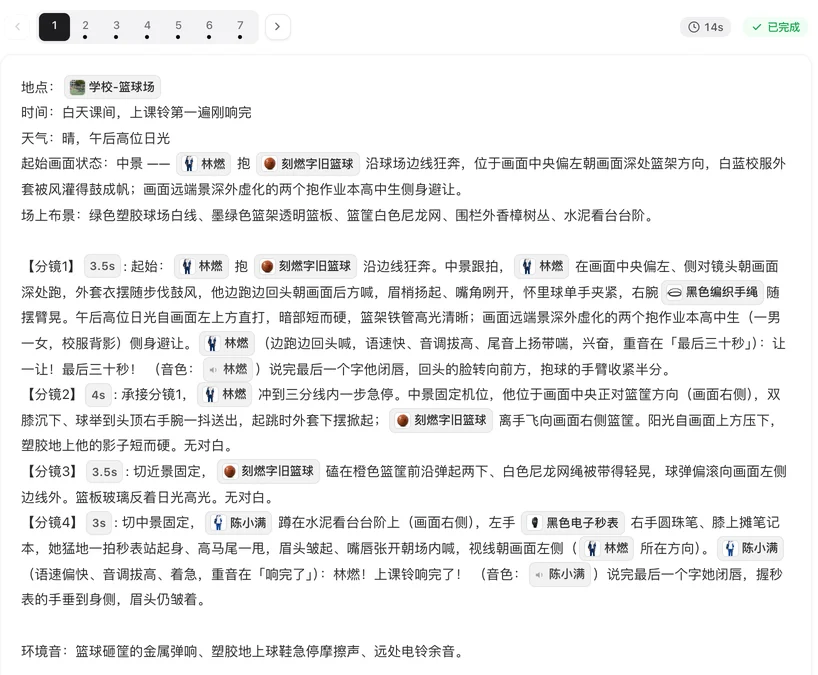
选按剧情重拍读完后,在第三步打开这一集看梗概:每个场景块以「说话人:台词」列出台词。替换保留原片的声音和台词,这一页讲的不适用于它。
台词怎么听
语音识别在每一镜自己的音频上跑。听到的字交给镜头描述当「这里说了这些话」;描述者再按脸认说话人、把台词写进那一镜。配乐下面的说话能处理;人群里喊、重口音、很轻的话是它失手的地方,这些宁可空着也不编。台词随后像剧本一样出现在梗概里:剧本里台词怎么写。
为什么引用不猜
放任一个视觉模型回答「这里说了什么」,同一镜它有时听到有时听不到,不确定时还会编合理的台词。把识别出的字钉进描述两样都止住;这一镜每次描述用的都是同样的话。
配乐
读片问一次原片有没有音乐、什么样的。有的话,这个描述成为这一集配乐的基调,复刻出来是同一路数的片子;原片的音轨本身从不使用。生成的片段不带自己的音乐,配乐按这一集的分镜规划、通常一到三首,混在说话声底下,和短剧里完全一样。这一集不走配乐时(配乐上线前就出过片的老集,或者没能规划出配乐的集),片段照旧由视频模型自己配乐。原片的环境声记下但不带。短剧的背景音乐怎么用。
台词语言
台词语言在上传那一屏选(选按剧情重拍时才有这一项),缺省中文,读片开始后不能改。听到的别的语言译成你选的那门;梗概、设定图、分镜的文字仍用中文写。第一步没有台词语言的选项,因为读片在那之前就跑完了。替换保留原片里的人声,所以没有这一项;替换项目之后改成按剧情重拍,台词是中文。读完之后。
漏了或听错了
梗概本身不能编辑,分镜会逐字照抄它的台词。先生成分镜,再打开台词该在的那一段,把台词连同说话人补上或改正;说话人认错了也这样改。编辑免费。生成分镜。
| 原片里 | 读片里 | 你的这一集里 |
|---|---|---|
| 一句清楚的台词 | 引用,标说话人 | 梗概里的一句台词 |
| 没人说话 | 镜头标无对白 | 没有台词 |
| 说不清的话 | 空着 | 在那一段里手动补 |
| 配乐 | 记下性质 | 成为这一集配乐的基调,混在说话声底下 |
| 环境声 | 记下 | 不带;分镜自己写 |
常见问题
为什么少了一句?
识别不出来。对照原片,分镜出来后在那一段里补。
原片的声音会用吗?
按剧情重拍不会:声音来自角色的音色设置,和任何项目一样。替换保留原片的声音。在 SceneMixer 里,按剧情重拍时声音来自角色的音色设置。
原片说的不是中文怎么办?
选按剧情重拍的话,读片时按你在上传那一屏选的台词语言写(缺省中文);替换保留原片的声音,说的还是原来的话。
原片的音乐会复用吗?
按剧情重拍不会:它的性质成为这一集配乐的基调,配乐按这一集的分镜规划,通常一到三首,混在说话声底下。替换保留原片的声音,音乐也在里面。
人群的喊声为什么没有台词?
群体噪声当背景声,不当台词。
更新于 2026 年 11 月 15 日